# Rainman Translate Book
[English](README.md) | 中文
面向 Codex、Claude Code 和 OpenClaw 的 Agent Skill,使用并行 subagent 将整本书(PDF/DOCX/EPUB)翻译成任意语言。

> 本项目受 [claude_translater](https://github.com/wizlijun/claude_translater) 启发。原项目以 shell 脚本为入口,配合 Claude CLI 和多个步骤脚本完成分块翻译;本项目则将流程重构为可在 Codex、Claude Code 和 OpenClaw 中使用的 Agent Skill,使用 subagent 按 chunk 并行翻译,并引入 manifest 驱动的完整性校验,将续跑和多格式输出整合为更统一的流水线。由于项目结构和实现方式均与原项目不同,本项目为独立实现,而非 fork。
---
## 工作原理
```
输入文件 (PDF/DOCX/EPUB)
│
▼
Calibre ebook-convert → HTMLZ → HTML → Markdown
│
▼
拆分为 chunk(chunk0001.md, chunk0002.md, ...)
│ manifest.json 记录每个 chunk 的 SHA-256 hash
▼
并行 subagent 翻译(默认 8 路并发)
│ 每个 subagent:读取 1 个 chunk → 翻译 → 写入 output_chunk*.md
│ 分批执行,控制 API 速率
▼
校验(manifest hash 比对,源文件↔输出文件 1:1 匹配)
│
▼
合并 → Pandoc → HTML(含目录)→ Calibre → DOCX / EPUB / PDF
```
每个 chunk 由独立的 subagent 翻译,拥有全新的上下文窗口。这避免了单次会话翻译整本书时的上下文堆积和输出截断问题。
## 功能特性
- **并行 subagent** — 每批 8 个并发翻译器,各自独立上下文
- **可续跑 + 精确重译** — chunk 级续跑,并用 `run_state.json` 追踪受术语表影响的重译范围
- **邻居上下文** — 每个 chunk 可读取相邻 chunk 的短只读摘录,用于代词和实体判断
- **Manifest 校验** — SHA-256 hash 追踪,防止过时或损坏的输出被合并
- **多格式输出** — HTML(含浮动目录)、DOCX、EPUB、PDF
- **可选输出控制** — 显式 EPUB 封面、自定义 temp root、面向用户的导出别名
- **多语言** — zh、en、ja、ko、fr、de、es(可扩展)
- **多格式输入** — PDF/DOCX/EPUB,Calibre 负责格式转换
## 前置要求
- **Agent 运行环境** — Codex、Claude Code 或 OpenClaw,已安装并可运行 Skill
- **Calibre** — `ebook-convert` 命令可用([下载](https://calibre-ebook.com/))
- **Pandoc** — 用于 HTML↔Markdown 转换([下载](https://pandoc.org/))
- **Python 3**,需要:
- `pypandoc` — 必需(`pip install pypandoc`)
- `beautifulsoup4` — 可选,用于更好的目录生成(`pip install beautifulsoup4`)
## 快速开始
### 1. 安装 Skill
#### Codex
```bash
npx skills add deusyu/translate-book -a codex -g
```
或手动安装:
```bash
mkdir -p ~/.agents/skills
git clone https://github.com/deusyu/translate-book.git ~/.agents/skills/translate-book
```
如果新安装的 Skill 没有出现,请重启 Codex。
#### Claude Code
```bash
npx skills add deusyu/translate-book -a claude-code -g
```
或手动安装:
```bash
mkdir -p ~/.claude/skills
git clone https://github.com/deusyu/translate-book.git ~/.claude/skills/translate-book
```
#### OpenClaw
```bash
openclaw skills install @deusyu/translate-book
```
### 2. 翻译一本书
#### Codex
在 Codex CLI 或 IDE 扩展中输入:
```text
$translate-book Translate /path/to/book.pdf into Chinese.
```
当请求与 Skill 描述匹配时,Codex 也可以自动选择该 Skill。
#### Claude Code 和 OpenClaw
直接告诉 Agent:
```text
translate /path/to/book.pdf to Chinese
```
在 Claude Code 中也可以使用斜杠命令:
```text
/translate-book translate /path/to/book.pdf to Japanese
```
Skill 自动处理完整流程 — 转换、拆分、并行翻译、校验、合并、生成所有输出格式。
### 3. 查看输出
所有文件在 `{book_name}_temp/` 目录下:
| 文件 | 说明 |
|------|------|
| `output.md` | 合并后的翻译 Markdown |
| `book.html` | 网页版,含浮动目录 |
| `book.docx` | Word 文档 |
| `book.epub` | 电子书 |
| `book.pdf` | 可打印 PDF |
## 仓库测试资产
- 需要纳入仓库的基准书输入,统一放在 `tests/baselines//`。
- 完整流水线跑出来的产物统一放在 `tests/.artifacts/`,不提交到版本库。
- 由于 `scripts/convert.py` 会把 `{book_name}_temp/` 写到**当前工作目录**下,仓库内的 baseline 测试应从 `tests/.artifacts/` 目录里启动,这样生成文件不会散落到仓库根目录。
### 完整基准测试示例
```bash
mkdir -p tests/.artifacts
cd tests/.artifacts
python3 ../../scripts/convert.py ../baselines/standard-alice/standard-alice.epub --olang zh
# 然后通过 skill 完成翻译
python3 ../../scripts/merge_and_build.py --temp-dir standard-alice_temp --title "test"
```
## 反馈与贡献
请优先提交详细的 GitHub issue,而不是直接从 pull request 开始。本项目按 AI 辅助的 skill pipeline 维护,任何变更都需要放在同一个由维护者掌握的上下文里,结合当前编排规则、chunk/manifest 契约、baseline 资产和发布流程一起评估。
Pull request 不是首选贡献入口,可能会被关闭并转为 issue 继续讨论。如果你已经有 patch,可以把思路、关键 diff、失败用例或验证结果写进 issue;维护者可能会据此重写或拆分实现,再决定是否合入。
一个有用的 issue 应包含:
- 当前行为与期望行为
- 输入格式和运行环境,例如 PDF/DOCX/EPUB、操作系统、Python、Calibre、Pandoc 版本
- 尽量小的复现步骤,或可公开使用的小样本文件
- 能说明问题的日志、截图或生成文件名
## 流程详解
### 第一步:转换
```bash
python3 scripts/convert.py /path/to/book.pdf --olang zh
```
Calibre 将输入文件转为 HTMLZ,解压后转为 Markdown,再拆分为 chunk(每个约 6000 字符)。`manifest.json` 记录每个源 chunk 的 SHA-256 hash,用于后续校验;`source_fingerprint.json` 则把 temp 目录与生成它的源文件字节绑定 — 若源文件被替换后重跑,会直接报错中止,而不是静默复用过时的 chunk。指纹机制之前创建的 temp 目录会在首次重跑时打印警告并被接管。
默认工作目录是当前目录下的 `{book_name}_temp/`。如果要换父目录,可使用 `--temp-root /path/to/work`;叶子目录名仍保持 `{book_name}_temp/`。
### 第一步半:术语表(保证全书译名一致)
每个 chunk 由独立的 fresh-context subagent 翻译 — 这意味着同一个专有名词在 100 个 chunk 之间可能出现多种译法。为此,skill 在翻译前会先构建术语表:
1. 抽样 5 个 chunk(首章、末章、3 个均匀分布的中间章节)。
2. 提取专有名词和反复出现的领域术语,给每个术语确定一个标准译法。
3. 写入 `/glossary.json`(schema 见下,可手动编辑)。
4. 运行 `python3 scripts/glossary.py count-frequencies `,统计每个术语在全书的出现次数(ASCII 术语用单词边界正则,避免 `cat` 误匹配 `category`;中日韩术语用子串匹配;单字汉字术语会被拒绝以防过度匹配;别名也计入所属术语的频次)。
5. 翻译每个 chunk 之前,主 agent 调用 `python3 scripts/glossary.py print-terms-for-chunk chunkNNNN.md`,将输出的 3 列(`原文 | 别名 | 译文`)markdown 表格作为硬性约束注入到该 chunk 的 prompt。术语选取 = (本 chunk 中出现原文或任一别名的术语) ∪ (全书出现频率 top-N 的术语)。
```json
{
"version": 2,
"terms": [
{"id": "Manhattan", "source": "Manhattan", "target": "曼哈顿",
"category": "place", "aliases": [], "gender": "unknown",
"confidence": "medium", "frequency": 12,
"evidence_refs": [], "notes": ""}
],
"high_frequency_top_n": 20,
"applied_meta_hashes": {}
}
```
已有的 v1 `glossary.json` 会在首次加载时自动升级为 v2。v2 禁止同一个表面词(原文或别名)同时归属于两个不同术语;如果 v1 文件存在同名(polysemous)的重复 source,升级会终止并给出消歧提示 — 手工修复后重新加载即可。
可在两次运行之间编辑 `glossary.json` 修正译法。已存在的 `glossary.json` 不会被覆盖 — 删除它才会重建。`scripts/run_state.py` 会记录每个 chunk 用到的术语表状态,因此后续术语表变化(包括 `target`、`category`、`aliases` 的编辑)只会重译受影响的 chunk(前提是该 chunk 已写入 run_state)。
### 第二步:翻译(并行 subagent)
Skill 分批启动 subagent(默认 8 路并发)。每个 subagent:
1. 读取一个源 chunk(如 `chunk0042.md`)
2. 翻译为目标语言
3. 使用该 chunk 的术语表和相邻 chunk 的短只读上下文
4. 将结果写入 `output_chunk0042.md`
5. 写入 `output_chunk0042.meta.json`,供术语表反馈合并
启动 subagent 前,`scripts/run_state.py plan ` 会判断哪些 chunk 需要翻译、哪些已有输出只需记录状态、哪些无需处理。只有在接管旧 temp 目录且明确希望现有输出按当前术语表重译时,才使用 `--retranslate-untracked`。如果运行中断,重新运行会跳过已有合法输出且状态仍有效的 chunk。翻译失败的 chunk 会自动重试一次。
### 第三步:合并与构建
```bash
python3 scripts/merge_and_build.py --temp-dir book_temp --title "《译后书名》"
```
可选输出参数:
```bash
python3 scripts/merge_and_build.py --temp-dir book_temp --title "《译后书名》" --cover cover.jpg --export-name "译后书名"
```
`--cover` 会把显式封面图传给 EPUB 的 Calibre 步骤。`--export-name` 会额外生成如 `译后书名.epub` 的别名副本,同时保留内部 canonical 的 `book.*` 产物。
合并前校验:
- 每个源 chunk 都有对应的输出文件(1:1 匹配)
- 源 chunk hash 与 manifest 一致(无过时输出)
- 输出文件不为空、非纯空白(whitespace-only)、可正常读取 — 空白 chunk 会中止合并,而不是静默丢失该段内容
校验通过后:合并 → Pandoc 生成 HTML → 注入目录 → Calibre 生成 DOCX、EPUB、PDF。
**注意:** `{book_name}_temp/` 是单次翻译运行的工作目录。如果修改了标题、作者、输出语言、模板或图片资源,建议使用新的 temp 目录,或先删除已有的最终产物(`output.md`、`book*.html`、`book.docx`、`book.epub`、`book.pdf`)再重跑。
## 项目结构
| 文件 | 用途 |
|------|------|
| `SKILL.md` | Agent Skill 定义 — 编排完整流程 |
| `scripts/convert.py` | PDF/DOCX/EPUB → Markdown chunks(经 Calibre HTMLZ) |
| `scripts/manifest.py` | Chunk manifest:SHA-256 追踪与合并校验 |
| `scripts/glossary.py` | 术语表管理:为每个 chunk 生成专属术语对照表,保证全书译名一致 |
| `scripts/chunk_context.py` | 为 subagent prompt 提供上一/下一 chunk 的只读摘录 |
| `scripts/meta.py` | 子 agent 单 chunk 观察文件 schema(`output_chunkNNNN.meta.json`) |
| `scripts/merge_meta.py` | 批次边界合并:子 agent 观察 → canonical 术语表 |
| `scripts/run_state.py` | 精确重译规划器和 `run_state.json` 记录器 |
| `scripts/merge_and_build.py` | 合并 chunks → HTML → DOCX/EPUB/PDF |
| `scripts/calibre_html_publish.py` | Calibre 格式转换封装 |
| `scripts/template.html` | 网页 HTML 模板,含浮动目录 |
| `scripts/template_ebook.html` | 电子书 HTML 模板 |
| `tests/baselines/` | 纳入仓库的完整链路 baseline 输入 |
| `tests/.artifacts/` | 被忽略的完整链路测试产物 |
## 常见问题
| 问题 | 解决方案 |
|------|----------|
| `Calibre ebook-convert not found` | 安装 Calibre,确保 `ebook-convert` 在 PATH 中 |
| `Manifest validation failed` | 源 chunk 在拆分后被修改 — 重新运行 `convert.py` |
| `was created from different source bytes` | temp 目录属于另一个源文件 — 删除 temp 目录或换一个 `--temp-root` |
| `Blank output` / `Empty output` | 某个 subagent 写出了空白或空的 chunk — 重新运行 skill 让它重译 |
| `Missing source chunk` | 源文件被删除 — 重新运行 `convert.py` 重新生成 |
| 翻译不完整 | 重新运行 Skill,会从中断处继续 |
| 修改标题、模板或图片后输出未更新 | 删除 temp 目录中的 `output.md`、`book*.html`、`book.docx`、`book.epub`、`book.pdf`,然后重跑 `merge_and_build.py` |
| 想去掉 PDF 输出中的页码 | 默认会自动识别单调递增的页码序列(如 `1, 2, 3, ...`)并删除,同时保留年份(`1984`)、章节编号、引用编号等离散的独立数字行。若识别不到你的页码格式,可给 `convert.py` 加 `--strip-page-numbers`,强制删除所有独立数字行。该标志在检测到已缓存的 `input.md` 或 `chunk*.md` 时会直接报错 — 需先删除这些缓存,标志才会生效 |
| `output.md exists but manifest invalid` | 旧输出已过时 — 脚本会自动删除并重新合并 |
| `Glossary upgrade rejected: duplicate source` | v2 不允许两个术语共用同一个 source/alias 表面词。手工编辑 `glossary.json` 消歧(例如把一个 source 从 `Apple` 改为 `Apple (Inc.)`)后重新加载。 |
| PDF 生成失败 | 确认 Calibre 已安装且支持 PDF 输出 |
## 后续规划
跟踪 [issue #7](https://github.com/deusyu/translate-book/issues/7) — chunk 之间的人名/术语不一致以及代词/性别错误。当前流水线已覆盖高频实体、别名/拼写漂移、相邻 chunk 的代词上下文,以及术语表变更后的精确重译。整书自然度校验仍是后续质量阶段。整体方案分为四个可独立交付的阶段。
### 设计原则
- **脚本做记账,LLM 做语义合并**。状态管理、schema 校验、去重、hash、IO 是确定性的 Python;命名、性别归属、别名判定、冲突解决交给 LLM。
- **共享状态单写者**。`glossary.json` 和 `run_state.json` 仅由主 agent 写入;子 agent 只读共享状态,并写入各自的 chunk meta 文件。无需加锁。
- **保守合并**。新实体必须有证据;别名合并需要 LLM 判断,不能仅靠字符串相似度;性别默认 `unknown`,仅在显式证据下才升级;canonical 值在冲突时不会被静默覆盖。
- **三层状态,三个独立文件**。`glossary.json`(canonical,子 agent 读取)、`output_chunkNNNN.meta.json`(子 agent 原始观察)、`run_state.json`(编排状态)。
### Phase 1 — 子 agent 反馈 + 术语表合并(已发布)
闭合读写回路。术语表 v2 新增 `id`、`aliases`、`gender`、`confidence`、`evidence_refs`、`notes`(v1 文件首次加载时自动升级;术语表现在是 3 列,`aliases` 参与选词链路)。子 agent 在输出译文的同时生成 `output_chunkNNNN.meta.json`。新增 `scripts/merge_meta.py`(`prepare-merge` / `apply-merge` / `status`)按批次执行保守合并:跨术语 surface form 唯一性、坏 meta 隔离(warn + skip + count)、`evidence_chunks` 与 `used_term_sources` 双路 confidence 升级、FIFO 上限 5。详见 SKILL.md Step 4 / Step 4.5 / Step 5。
### Phase 2 — 代词的邻居上下文(已发布)
`scripts/chunk_context.py` 为每个子 agent prompt 注入 `prev_excerpt`(上一个 chunk 末尾约 300 字)和 `next_excerpt`(下一个 chunk 开头约 300 字),仅作只读上下文参考。不新增状态文件。
### Phase 3 — 精确重译(已发布)
Phase 1 的批次反馈只能向前优化。精确重译通过 `scripts/run_state.py` 和 `run_state.json` 闭合向后的回路:按 chunk 跟踪 `glossary_version_used`、`entity_ids_used`、`output_hash`、源 hash、以及选中实体的 hash;五条规划规则覆盖缺失/空输出、manifest 源文件漂移、未记录输出、记录后的源文件漂移、以及术语选择/术语 hash 变化。
### Phase 4 — 冷启动预热(实验性,依赖 Phase 1 的实际数据)
Phase 1 让术语表按批次增长,因此第一批看到的术语表最小,drift 风险最高。可能的方案:顺序冷启动、可变并发、或跳过预热。决策权属于实际跑过完整书的人。
> Phase 4 仍取决于真实书籍运行数据。已发布的 schema 后续如果暴露问题,也应通过兼容性迁移继续演进。
### 平行线路 — Pipeline / UX backlog(部分已发布,独立于 issue #7)
最近几轮 PR 讨论也暴露出一些有价值的工作流改进,但它们都不属于“一次性小补丁”:会触及仓库契约(产物命名、temp-dir 行为、清理语义、或 EPUB 兼容性边界)。当前状态:
- **显式 EPUB 封面支持(已发布)**。`merge_and_build.py --cover ` 会在 HTML -> EPUB 的 Calibre 步骤透传封面图。`--cover-from ` / EPUB 封面自动提取仍不纳入当前范围,等项目准备好承担不同 EPUB 包布局的解析兼容性后再考虑。(context: closed #3)
- **可配置的 temp 工作目录位置(已发布)**。`convert.py --temp-root ` 保留默认 cwd-local `{book_name}_temp/` 行为,只有显式传参时才改变父目录。(context: closed #4)
- **更安全的 Calibre/Pandoc 噪声清理(部分已发布)**。页码和 Calibre marker 清理已有回归测试保护,保留年份、章节编号和非单调独立数字。后续清理规则继续在测试下增量增加。(context: closed #5)
- **可选的面向用户导出文件名(已发布)**。`merge_and_build.py --export-name ` 生成 alias/copy,同时流水线内部 canonical 产物仍保持 `book.html`、`book_doc.html`、`book.docx`、`book.epub`、`book.pdf`。(context: closed #6)
## Star History
如果这个项目对您有帮助,请考虑为其点亮一颗 Star ⭐!
[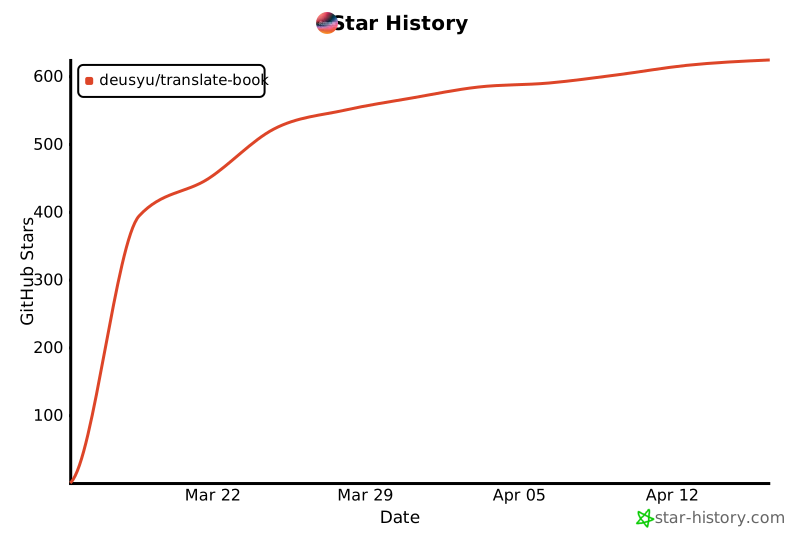](https://star-history.com/#deusyu/translate-book&Date)
## 赞助
如果这个项目帮你节省了时间,欢迎赞助支持后续维护和改进。
[](https://github.com/sponsors/deusyu)
## License
[MIT](LICENSE)